Таблицы и колонки
Ячейки таблиц переводятся по отдельности и остаются в своей сетке. Колонки, оглавления и подписи к рисункам сохраняют порядок и положение.

Загрузите PDF на английском, немецком, китайском или другом языке и получите русский документ с теми же таблицами, колонками и иллюстрациями. Перевод можно поправить в редакторе, а результат скачать как PDF с поиском или DOCX.
Без регистрации: первые 3 страницы · 5 страниц бесплатно после регистрации · Экспорт PDF и DOCX
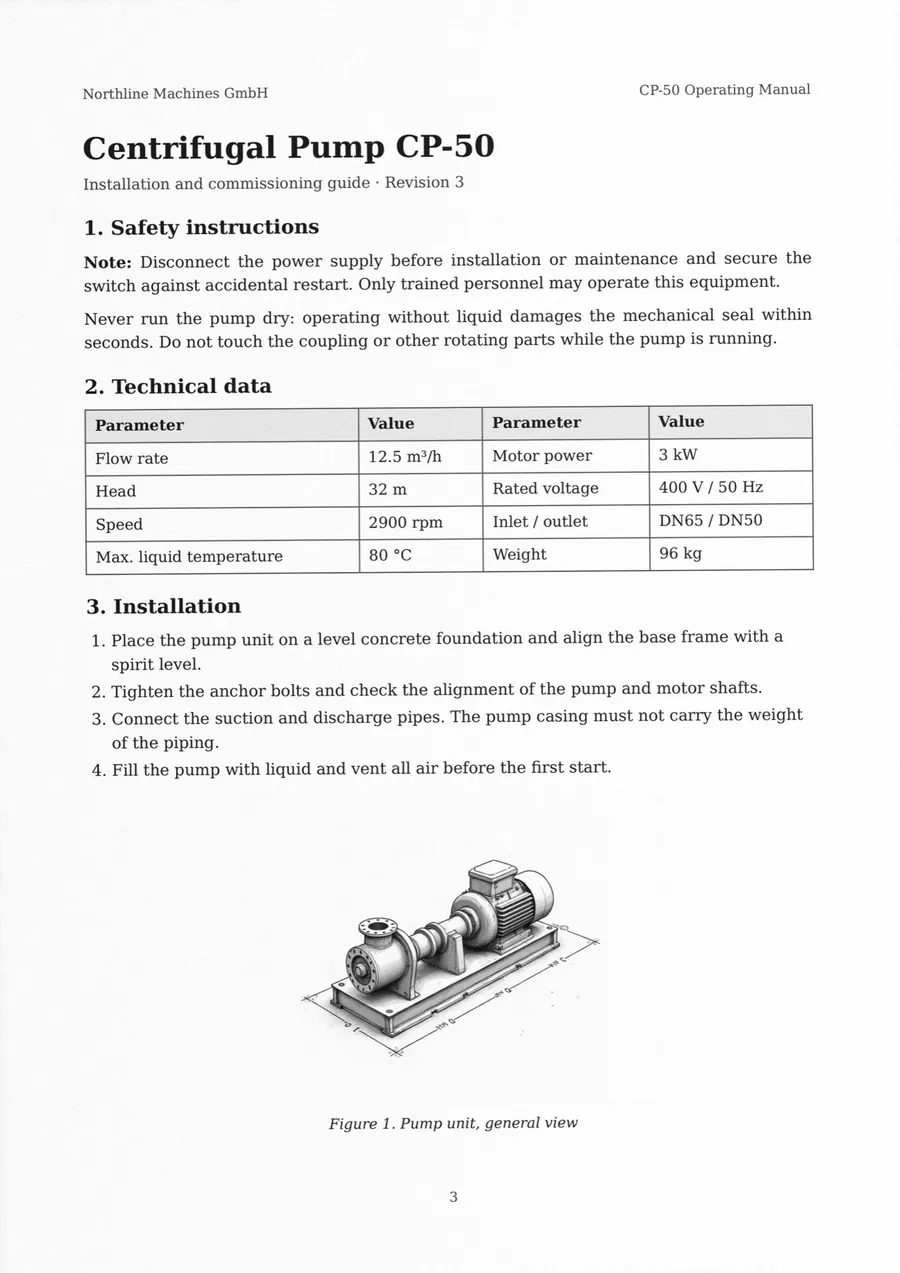
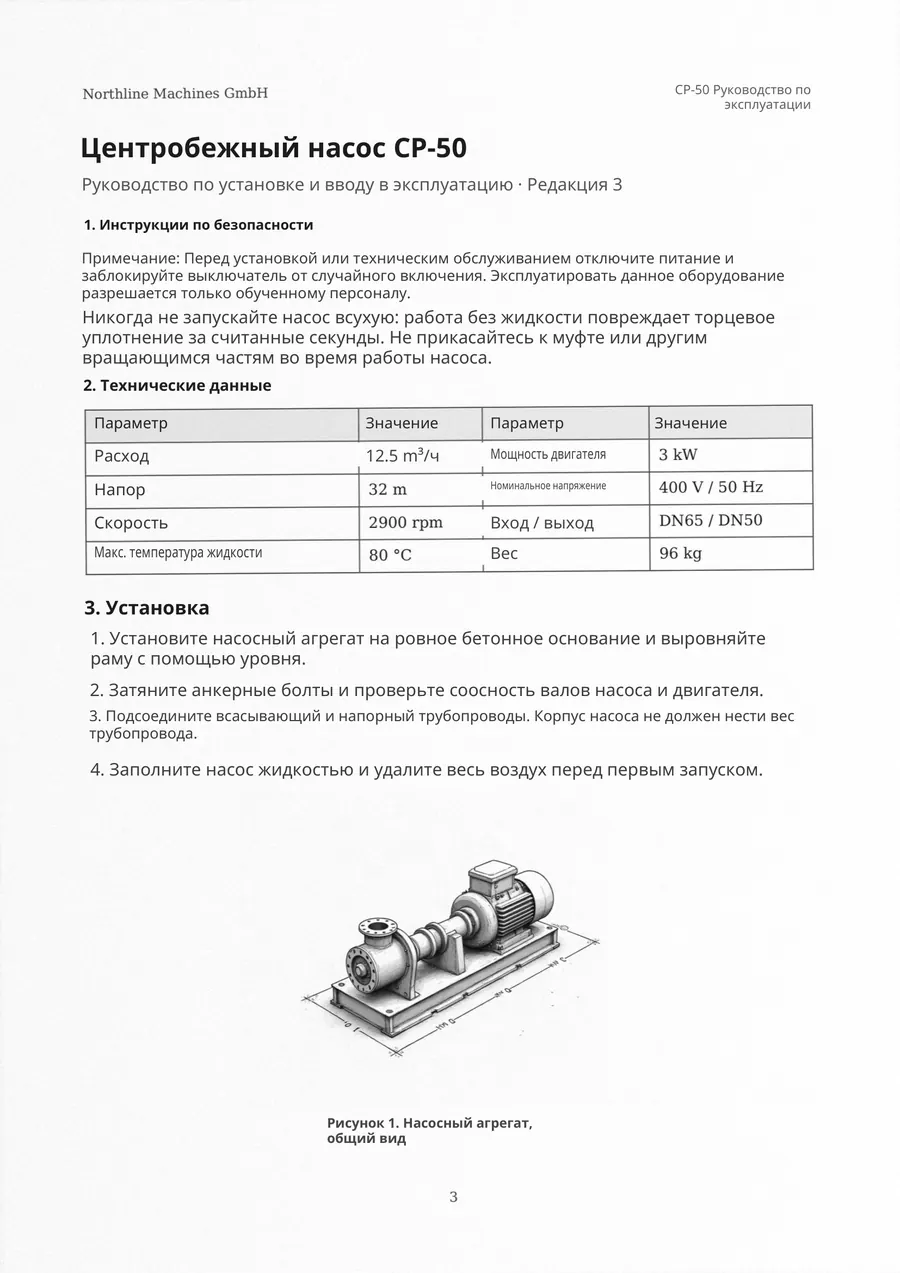
Обычный переводчик возвращает сплошной текст, и вёрстку приходится собирать заново. OCRika переводит блоки прямо на странице.
Ячейки таблиц переводятся по отдельности и остаются в своей сетке. Колонки, оглавления и подписи к рисункам сохраняют порядок и положение.
Текст распознаётся на сканах, фото с телефона и PDF без текстового слоя. Наклон и шум страницы не мешают переводу.
Названия компаний и продуктов, модели, коды, стандарты, единицы и числа не переводятся и не искажаются. Логотипы, печати и подписи остаются как в оригинале.
Оригинал и перевод открыты рядом. Исправьте формулировку, размер шрифта или положение блока прямо на странице, прежде чем скачать документ.
Готовый PDF содержит текстовый слой: документ можно искать и по русскому переводу, и по исходному тексту.
Скачайте PDF, который выглядит как оригинал, или редактируемый DOCX, чтобы продолжить работу с текстом в Word.
Прогресс виден по этапам. Если на странице что-то не так, её можно поправить отдельно, не переводя весь документ заново.
Загрузить PDFУкажите язык оригинала и выберите русский как язык перевода.
Сравните страницы рядом и исправьте то, что нужно, во встроенном редакторе.
PDF с сохранённой вёрсткой и поиском по тексту или DOCX.
Загрузите документ, проверьте перевод и скачайте результат в PDF или DOCX.
Полная инструкция и советы ↗Фоновая музыка без закадровой речи: Sascha Ende, Happy Beats & Business Moves Vol. 11, лицензия CC BY 4.0.
Да. OCRika распознаёт текст на сканах и фотографиях документов, затем переводит его и собирает страницу заново поверх исходного изображения. Текстовые PDF обрабатываются так же.
Да. Таблицы, колонки, оглавления, иллюстрации, логотипы, печати и подписи остаются на своих местах, а переведённый текст вписывается в исходные рамки блоков.
OCRika распознаёт более 100 языков, в том числе английский, немецкий, французский, китайский и японский. Язык определяется для каждого блока, поэтому страница, где смешаны, например, английский и немецкий, тоже переводится целиком.
Да. Во встроенном редакторе оригинал и перевод открыты рядом: можно исправить текст, размер шрифта и положение блоков, а затем экспортировать документ.
Да. Кнопка «Выделить область» в редакторе: обведите участок на исходной странице и выберите «Текст» — он распознается и переведётся заново — или «Изображение», чтобы оставить схему, логотип или печать как в оригинале, без перевода.
Да. Готовый PDF содержит текстовый слой: искать можно и по русскому переводу, и по исходному тексту. Также доступен экспорт в редактируемый DOCX.
Попробовать можно без регистрации: переведём первые 3 страницы одного документа. После регистрации 5 страниц бесплатно. Дальше — пакеты страниц: 30 страниц за 450 ₽, 100 за 1 290 ₽, 500 за 5 450 ₽, 1 000 за 8 900 ₽. Точная стоимость показывается в интерфейсе до оплаты.
Страницы распознаются на инфраструктуре OCRika и не отправляются во внешние OCR-сервисы. Сервису перевода передаётся только текст с замаскированными названиями, кодами и числами — не изображения страниц. Документы и результаты хранятся 60 дней с момента загрузки, затем удаляются автоматически — за несколько дней до этого в приложении появится предупреждение.